模拟芯片利用50万个闪存单元运行大型傅里叶变换
桑迪亚、Infineon和亚利桑那州立大学的研究人员将快速傅里叶变换算法改造用于模拟存内硬件。
作者: Letizia Giugliano
阅读约3分钟由人工智能辅助撰写 · 审校与批准:Giovanni Sapere
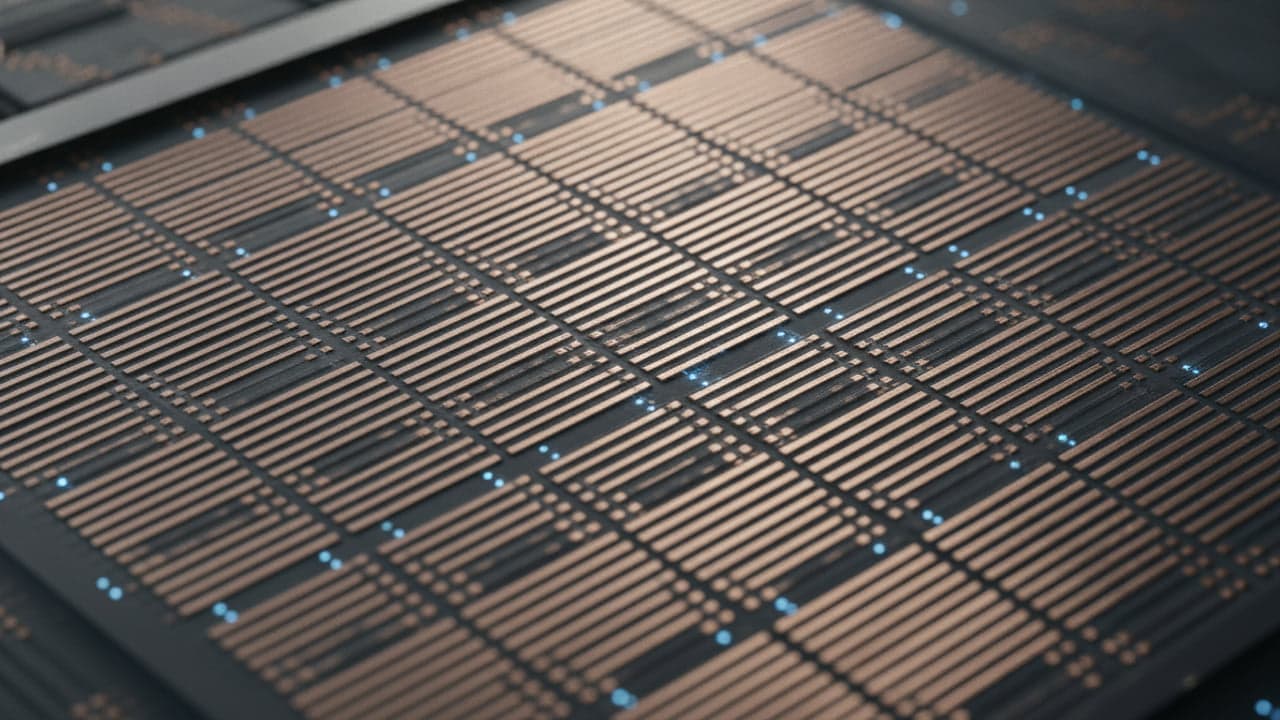
来自桑迪亚国家实验室(Sandia National Laboratories)、Infineon Technologies和亚利桑那州立大学(Arizona State University)的工程师,把快速傅里叶变换算法改造用于模拟硬件。他们的系统将数字处理步骤与在50多万个闪存单元上执行的模拟矩阵运算相结合,来计算大型傅里叶变换。
把数字算法映射到物理存储阵列
傅里叶变换把复杂信号分解为各个频率,以发现声音、雷达和数字图像中隐藏的模式,这些技术对机器人和太空探索至关重要。标准计算系统使用快速傅里叶变换(即FFT)来计算这些信号。其数学形式依赖O(N log N)的缩放规律,把大型变换递归地分解为较小的部分,以加快数字微处理器上的计算。模拟硬件以连续电量处理数据,能耗更低,但它此前难以运行大型变换,因为该算法是为数字逻辑量身定制的,这是发表在Nature Electronics的研究所述。
模拟存内计算作为矩阵乘法的低功耗加速器日益受到关注,而矩阵乘法是人工智能模型的核心运算。然而,把FFT的分治策略映射到模拟芯片上,一直是个未解决的难题。团队通过把算法的递归分解与大型物理存储块相结合,解决了这一限制。
“多年来,我们的团队和许多其他团队一直在探索模拟存内计算,把它作为矩阵乘法的一种非常高效的加速器。”
——T. Patrick Xiao,桑迪亚国家实验室
用SONOS闪存单元计算65,536点变换
一旦子问题的规模与硬件的物理阵列相匹配,研究人员就停止对傅里叶变换的数学划分。这种混合创新使系统能够在存储阵列内部并行完成关键的矩阵计算,而数字电路则完成其余运算。为测试该架构,研究小组把离散傅里叶变换系数直接写入SONOS闪存器件,TechXplore报道。
SONOS单元把电荷存储在超薄绝缘层内,无需持续供电即可保留数值数据。团队在存储阵列内配置了一个512×1,024的块,其中放入256点离散傅里叶变换矩阵。通过同时运行50多万个闪存器件,该模拟处理器成功完成了65,536点FFT,没有出现灾难性的信号误差累积。
超越人工智能工作负载的信号处理
此前的模拟实现只演示过最多64点或128点的小型变换,之后噪声就会使计算质量下降。通过高精度控制SONOS单元,团队在50万个元件上同时保持了精确的矩阵计算。在实际测试中,该混合平台处理了包括雷达处理、图像去模糊和音频滤波在内的任务,证明存内模拟架构能够应对远超人工智能常规矩阵乘法的工作负载。随着研究人员完善这项发明,这一突破还可能为新的专利申请和低功耗信号处理的商业应用铺平道路。
另请阅读The Patent:OpenAI自主流水线发现948个Linux内核缺陷
由英文原文自动翻译. 阅读原文
The Patent ® 编辑部的文章,借助人工智能,依据编辑部选定的来源撰写。审校、更正及批准发布:Giovanni Sapere。责任出版方:WitUp Ltd。