Une puce analogique calcule de grandes transformées de Fourier grâce à un demi-million de cellules de mémoire flash
Des chercheurs de Sandia, d'Infineon et de l'Arizona State University adaptent l'algorithme de transformée de Fourier rapide à un matériel analogique à calcul en mémoire.
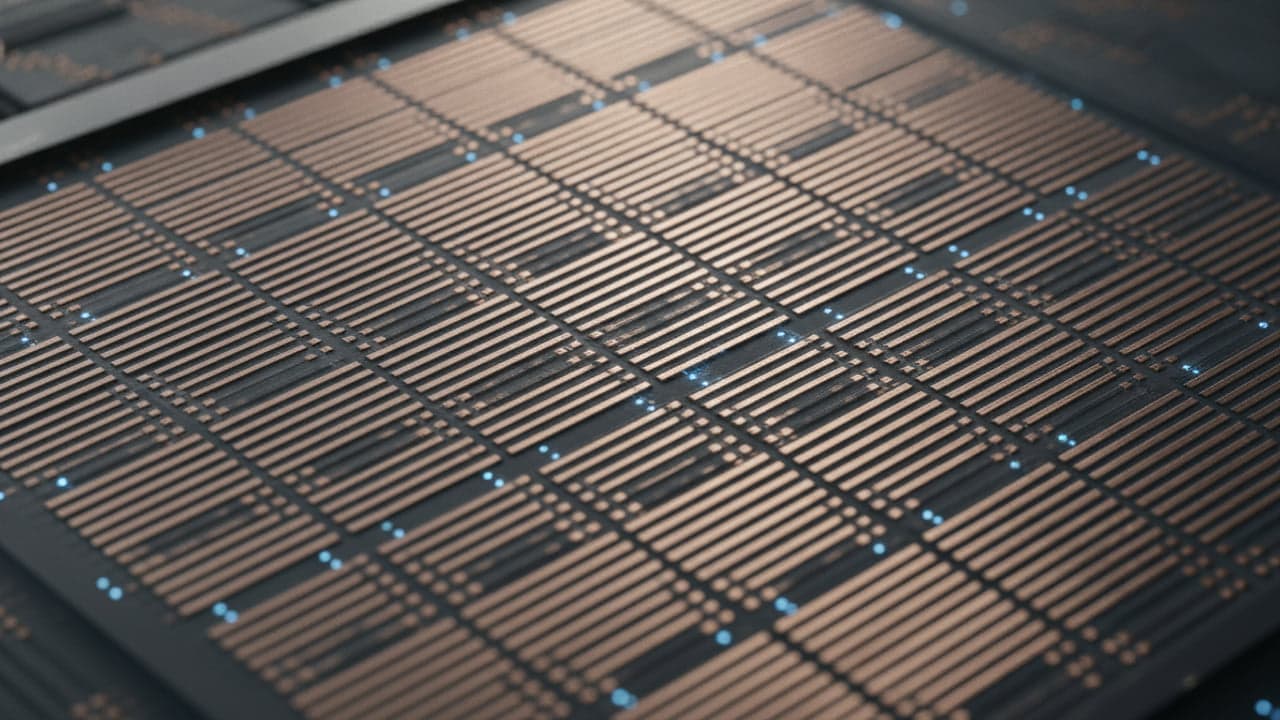
Des ingénieurs des Sandia National Laboratories, d'Infineon Technologies et de l'Arizona State University ont adapté l'algorithme de transformée de Fourier rapide à du matériel analogique. Leur système calcule de grandes transformées de Fourier en associant des étapes de traitement numérique à des opérations matricielles analogiques exécutées sur plus de 500 000 cellules de mémoire flash.
Transposer un algorithme numérique sur des matrices de mémoire physiques
Les transformées de Fourier décomposent des signaux complexes en leurs fréquences individuelles afin de révéler des motifs cachés dans le son, le radar et l'imagerie numérique, des technologies essentielles pour la robotique et l'exploration spatiale. Les systèmes informatiques classiques calculent ces signaux à l'aide de la transformée de Fourier rapide, dite FFT. Sa formulation mathématique repose sur une loi d'échelle en O(N log N) : elle divise récursivement les grandes transformées en morceaux plus petits pour accélérer les calculs sur les microprocesseurs numériques. Si le matériel analogique traite les données sous forme de grandeurs électriques continues avec une consommation d'énergie moindre, il peinait jusqu'ici à exécuter de grandes transformées, car l'algorithme était conçu pour la logique numérique, selon des recherches publiées dans Nature Electronics.
Le calcul analogique en mémoire s'est imposé comme un accélérateur à faible consommation pour les multiplications matricielles, opération centrale des modèles d'intelligence artificielle. Toutefois, transposer la stratégie « diviser pour régner » de la FFT sur des puces analogiques restait un problème non résolu. L'équipe a contourné cette limite en combinant la décomposition récursive de l'algorithme avec de grands blocs de mémoire physiques.
« Pendant des années, notre groupe et bien d'autres ont exploré le calcul analogique en mémoire comme un accélérateur très efficace pour les multiplications matricielles. »
— T. Patrick Xiao, Sandia National Laboratories
Calculer une transformée à 65 536 points avec des cellules flash SONOS
Les chercheurs ont interrompu la division mathématique de la transformée de Fourier dès que la taille du sous-problème correspondait à la matrice physique du matériel. Cette innovation hybride permet au système d'effectuer en parallèle les calculs matriciels essentiels à l'intérieur de la matrice mémoire, tandis que des circuits numériques terminent les opérations restantes. Pour tester l'architecture, le groupe a programmé directement les coefficients de la transformée de Fourier discrète dans des dispositifs de mémoire flash SONOS, comme le rapporte TechXplore.
Les cellules SONOS stockent une charge électrique dans une couche isolante ultra-fine, qui conserve les données numériques sans alimentation continue. L'équipe a configuré un bloc de 512 × 1 024 au sein de la matrice mémoire, avec une matrice de transformée de Fourier discrète à 256 points. En faisant fonctionner simultanément plus de 500 000 dispositifs flash, le processeur analogique a réalisé avec succès une FFT à 65 536 points sans subir d'accumulation catastrophique d'erreurs de signal.
Traitement du signal au-delà des charges de travail d'intelligence artificielle
Les implémentations analogiques antérieures n'avaient démontré que de petites transformées, jusqu'à 64 ou 128 points, avant que le bruit ne dégrade le calcul. En contrôlant les cellules SONOS avec une grande précision, l'équipe a maintenu des calculs matriciels exacts sur un demi-million de composants à la fois. Lors de tests pratiques, la plateforme hybride a traité des tâches telles que le traitement radar, la restauration d'images floues et le filtrage audio, prouvant que les architectures analogiques en mémoire peuvent traiter des charges bien éloignées de la multiplication matricielle de routine pour l'intelligence artificielle. À mesure que les chercheurs affinent l'invention, cette percée pourrait aussi ouvrir la voie à de nouveaux dépôts de brevets et à des applications commerciales dans le traitement du signal à faible consommation.
À lire aussi sur The Patent : Un pipeline autonome d'OpenAI détecte 948 failles du noyau Linux
Traduit automatiquement de l’original en anglais. Lire l’original